온톨로지 뭐길래: 엔비디아 Auto Ontology가 깃허브 1위

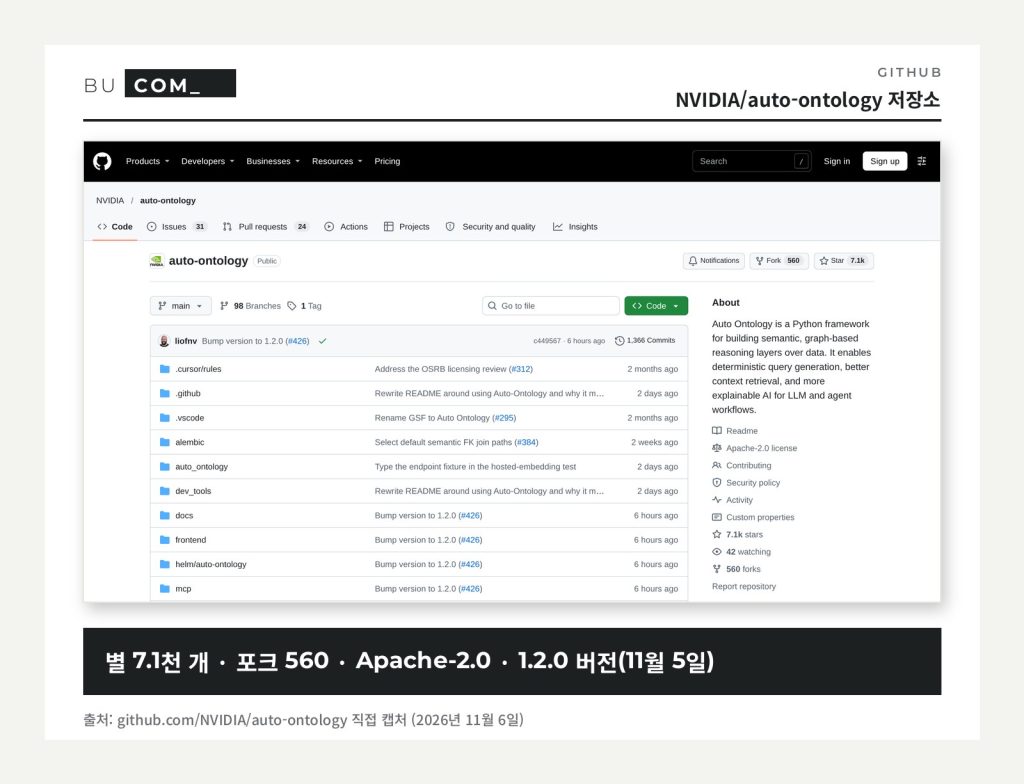
오늘 아침 깃허브 트렌딩(급상승 저장소) 맨 위에 엔비디아 이름이 올라와 있었어요. 저장소 이름은 auto-ontology. 하루 만에 별이 2,707개 붙었더라고요.
이름부터 낯설죠. 온톨로지(ontology)는 원래 철학 용어인데, 데이터 쪽에서는 “이 회사 데이터에서 ‘매출’은 어느 표 어느 칸이고, ‘고객’과 ‘주문’은 어떻게 이어지는지”를 정리한 뜻 지도를 말해요. 엔비디아가 이걸 AI가 자동으로 만들어 주는 도구를 오픈소스로 내놓은 겁니다.
AI한테 매출을 물으면 왜 틀릴까
요즘 AI 에이전트는 문서도 찾고 회사 데이터베이스에 SQL(데이터베이스 질의 언어)도 직접 날려요. 문제는 숫자예요. README 첫 문단에 이런 말이 있어요. “매출 숫자를 빨리 답해도, 그 숫자가 틀리면 아무 가치가 없다.”
회사 DB에는 표가 수백 개 있고, ‘매출’이라는 말이 부서마다 다른 칸을 가리키기도 해요. AI는 표 이름과 칸 이름만 보고 짐작해서 SQL을 쓰니, 엉뚱한 표를 붙이거나 계산 방식을 매번 다르게 하는 일이 생깁니다. Auto Ontology는 그 사이에 “어디에 뭐가 있고, 무슨 뜻이고, 어떻게 계산하는지”를 알려 주는 층을 하나 끼워 넣는 도구예요.
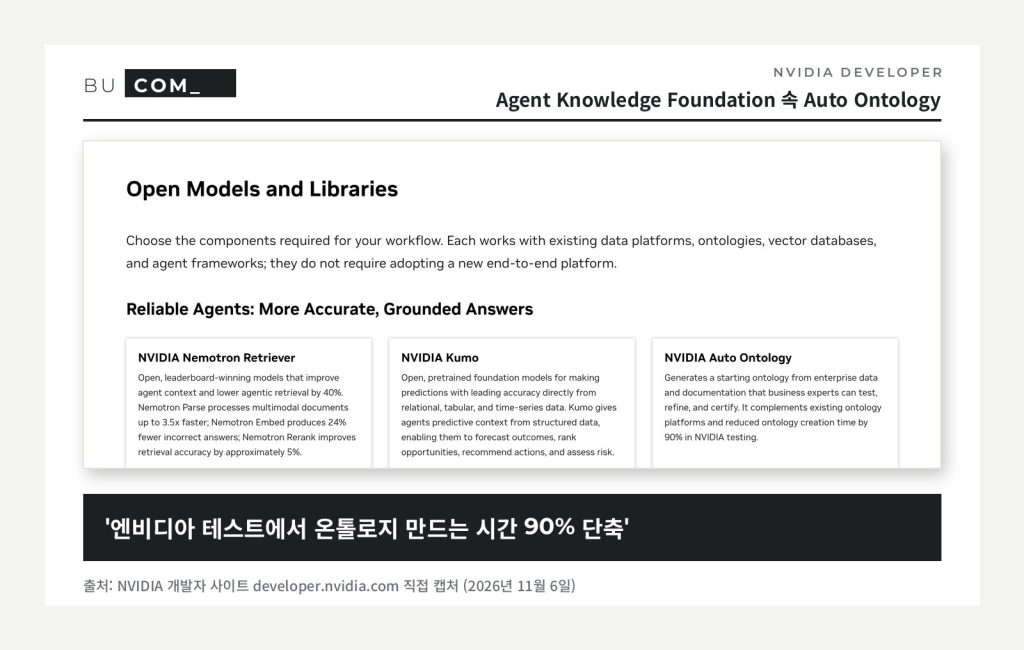
엔비디아는 10월 21일 공식 블로그에서 Agent Toolkit을 넓히면서 Agent Knowledge Foundation이라는 묶음을 발표했는데, Auto Ontology는 그 안의 새 라이브러리로 소개됐어요. 개발자 사이트 설명으로는 기업 데이터와 문서로 ‘출발점이 되는 온톨로지’를 만들고, 업무 전문가가 시험·수정·인증하는 구조예요. 엔비디아 자체 테스트에서 온톨로지 만드는 시간이 90% 줄었다고 하는데, 이건 회사가 밝힌 수치이고 문자→SQL 정확도 같은 외부 검증 숫자는 아직 README에 없어요.
온톨로지가 어떻게 만들어지나
README에 적힌 흐름은 세 단계예요. AI가 초안을 만들고(Generate), 사람이 확인해 인증하고(Certify), 에이전트가 그걸 보고 답한다(Answer).
온톨로지 안에는 세 가지가 들어가요.
- 용어(Terms) — ‘고객’, ‘송장줄’ 같은 업무 개념과 설명·동의어, 그리고 실제로 담긴 칸
- SQL 속성 — 마진, 누적 합계처럼 검토를 거친 계산식. 에이전트가 이걸 다시 써서 매번 같은 방식으로 계산
- 관계 — 표끼리 어떻게 붙는지. 키와 실제 데이터를 보고 추론
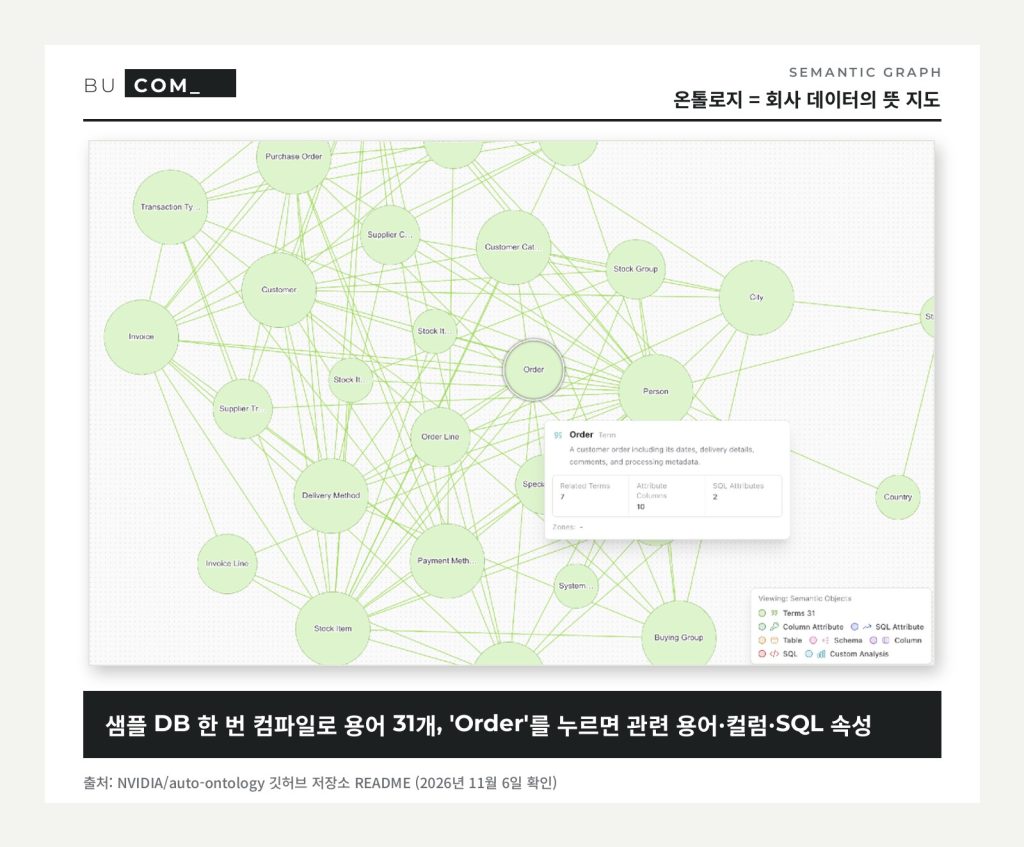
마이크로소프트 샘플 판매 DB(Wide World Importers)로 한 번 돌렸더니 용어 31개짜리 온톨로지가 나왔다고 해요. 웹 화면에서 그래프로 볼 수 있고, ‘주문(Order)’을 누르면 관련 용어 7개, 연결된 칸 10개, SQL 속성 2개가 뜹니다.
질문 하나를 넣으면 생기는 일
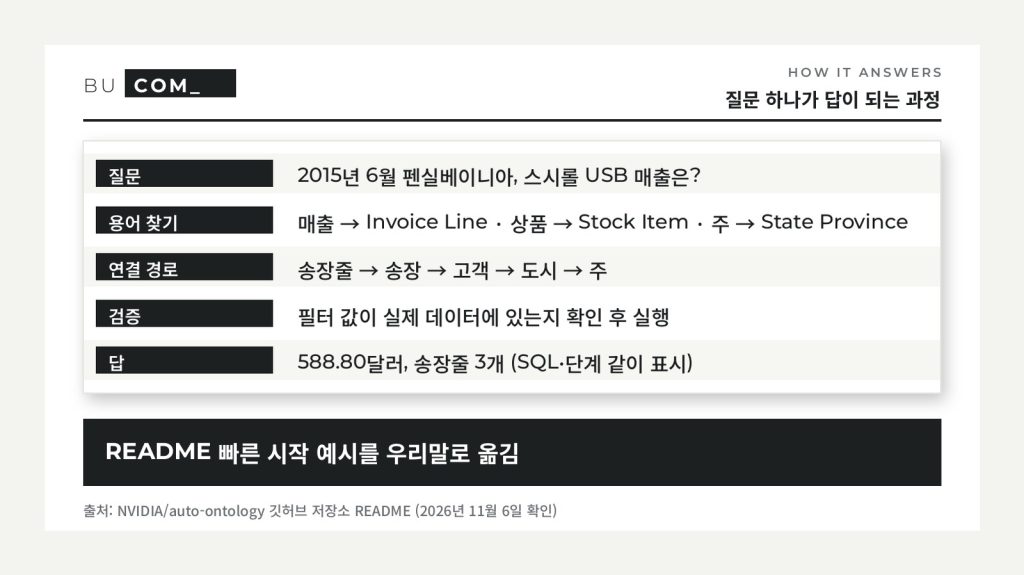
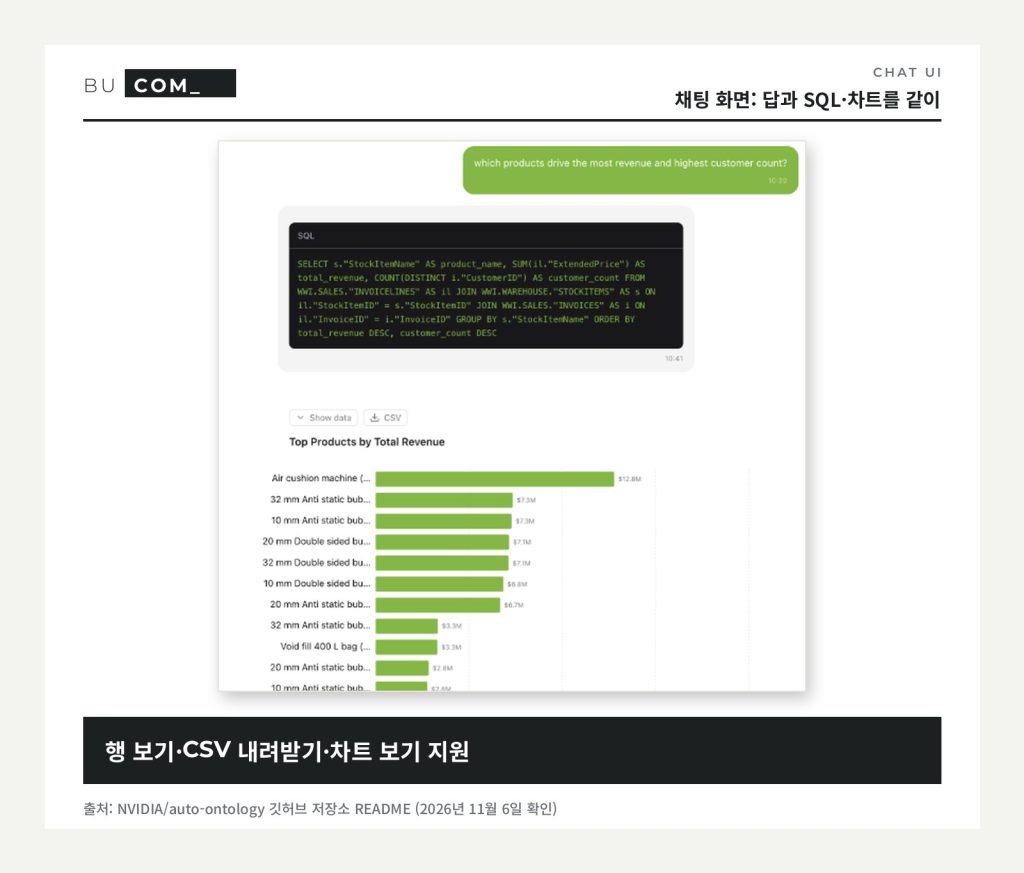
README 빠른 시작 예시가 이해하기 제일 좋았어요. “2015년 6월 펜실베이니아에서 스시롤 모양 USB 매출이 얼마였나?” 하고 물으면, 에이전트가 ‘매출’·’상품’·’주’를 온톨로지 용어로 바꾸고, 그 관계를 따라 표 여섯 개를 이어 붙인 뒤, 필터 값이 실제 데이터에 있는지 확인하고 나서 실행해요. 답은 588.80달러, 송장줄 3개. SQL과 거친 단계가 같이 나오니 사람이 원본과 대조할 수 있어요.
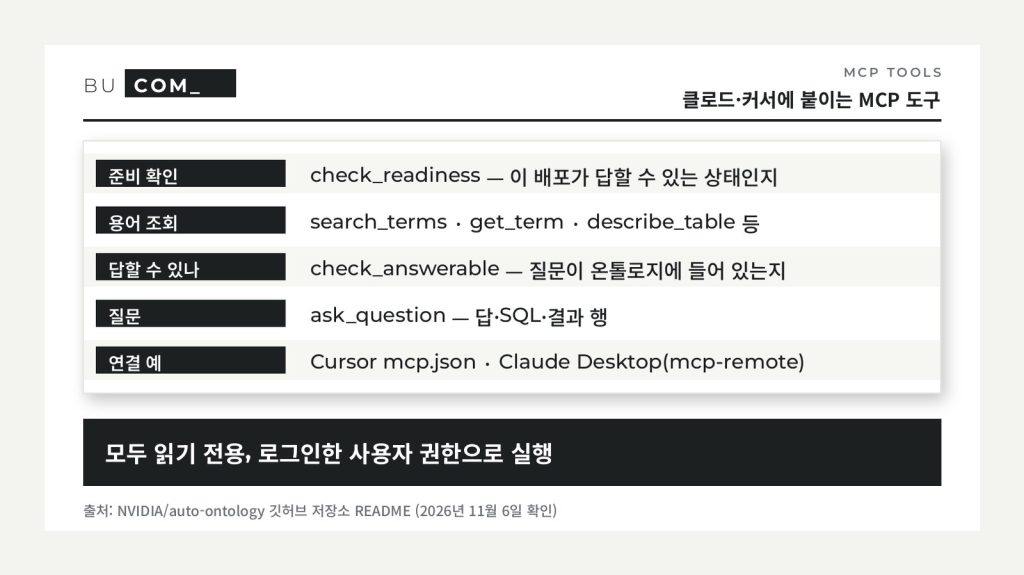
더 마음에 든 건 반대 경우예요. 이 샘플 DB엔 광고비 데이터가 없는데, “광고 수익률(ROAS)은?” 하고 물으면 MCP로 연결된 에이전트가 먼저 check_answerable로 확인하고 “광고비 데이터가 없어서 계산 못 해요, 매출로 대신 볼까요?” 하고 되물어요. 모르는 걸 그럴듯하게 지어내지 않는다는 것, 회사 데이터에선 이게 제일 중요하죠.
설치는 누가 할 수 있나
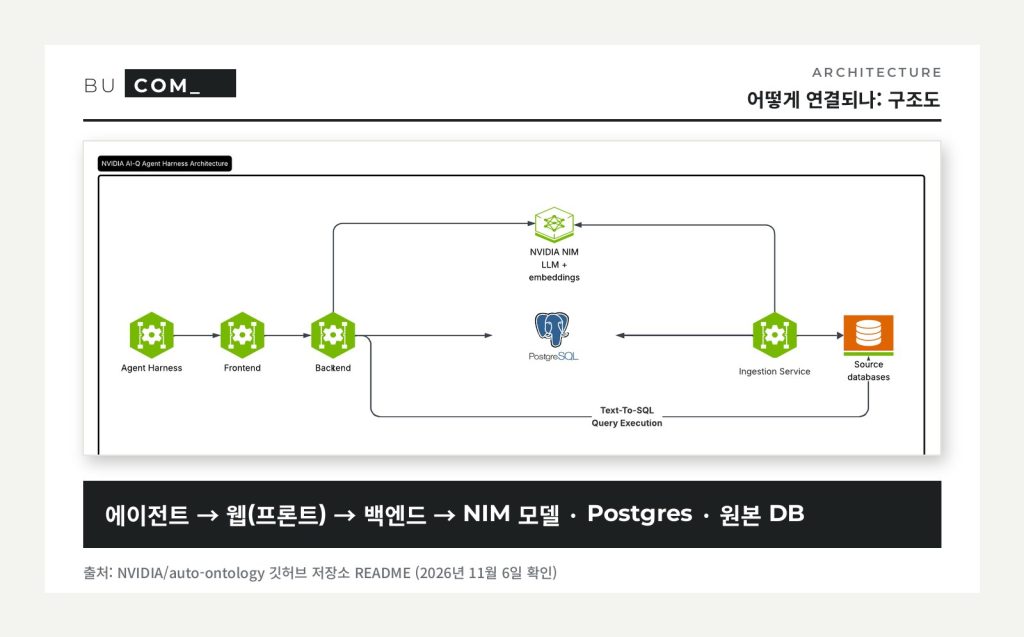
솔직히 일반 PC 사용자가 깔아 볼 물건은 아니에요. Docker Compose로 웹(Next.js), 백엔드(FastAPI), 수집 서비스, Postgres+pgvector까지 여러 컨테이너를 띄우고, 모델은 엔비디아 NIM(엔비디아가 제공하는 AI 모델 API)을 써서 build.nvidia.com에서 받은 API 키가 있어야 해요. 기본 모델은 Nemotron 3.5 Lightning이고, OpenAI 호환 주소면 다른 모델로 바꿀 수 있다고 적혀 있어요.
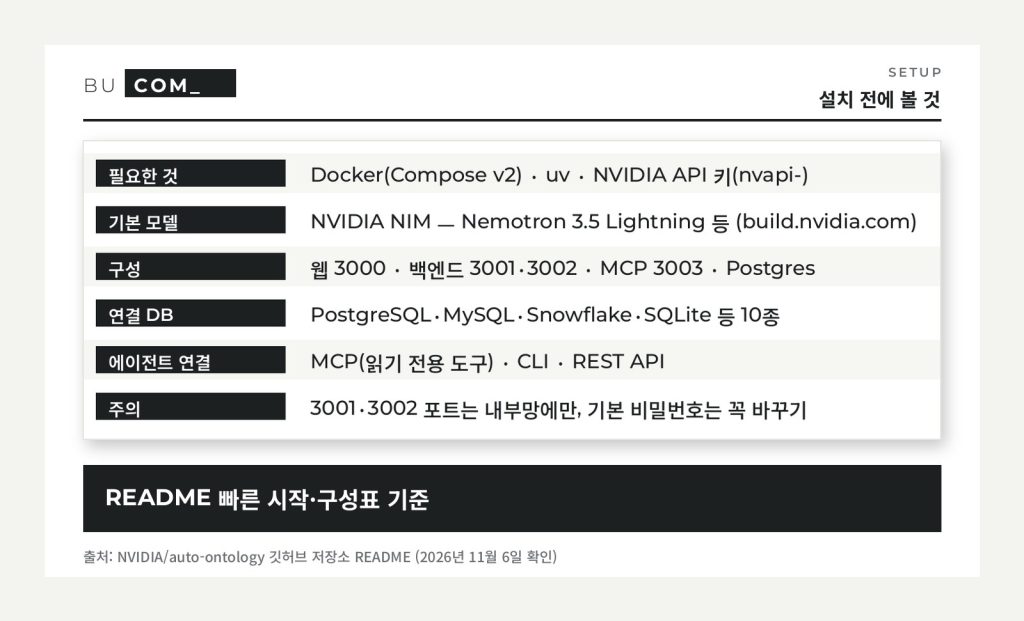
빠른 시작은 대략 이 순서예요(README 기준, 저는 이 라즈베리파이에서 돌려 보진 않았어요).
git clone https://github.com/NVIDIA/auto-ontology.git && cd auto-ontology
cp .env.example .env          # API 키·비밀번호 채우기
docker compose up -d --wait postgres
# 샘플 DB 넣기 (auto-ontology-eval 저장소의 seed 스크립트)
docker compose up -d --build
# http://localhost:3000 접속 → Settings → Semantic Compilation 켜기
README가 직접 경고하는 부분도 있어요. Postgres·pgAdmin·웹이 호스트에 열리니 기본 비밀번호는 꼭 바꾸고, 3001·3002 포트는 내부망에만 두라고요. 백엔드는 앞단이 넘겨주는 사용자 정보를 그대로 믿고, 수집 서비스는 자체 인증이 없거든요. 예측 기능(KumoRFM)을 켜면 연결된 표를 외부 서비스로 올리니 회사 데이터 검토부터 하라는 말도 있어요.
클로드·커서에 붙이는 MCP
이 도구가 개발자들 사이에서 빠르게 퍼진 이유는 MCP(AI 앱에 도구를 연결하는 표준) 서버가 같이 있어서일 거예요. Cursor나 Claude Desktop 설정 파일에 주소 한 줄 넣으면, 에이전트가 온톨로지에서 용어를 찾고 질문을 던질 수 있어요. 도구는 모두 읽기 전용이고 로그인한 사용자 권한으로만 돌아요.
연결할 수 있는 DB는 PostgreSQL, MySQL, Databricks, Snowflake, ClickHouse, Trino, Apache Kyuubi, HeavyDB, DuckDB, SQLite 10종이에요. 라이선스는 Apache-2.0이라 회사에서 가져다 써도 되지만, 외부 기여(풀 리퀘스트)는 받지 않고 이슈만 받는다고 적혀 있어요.
제 생각엔, 방향은 맞아요
제 생각엔 AI가 회사 숫자를 다루는 데서 막히는 건 모델 성능보다 ‘뜻’이에요. 같은 매출이라도 반품을 빼느냐 마느냐로 숫자가 갈리는데, 그걸 사람이 한 번 정해 두고 AI가 따르게 한다는 접근은 현장에서 꼭 필요한 부분 같아요. 엔비디아가 지난번 OpenShell로 에이전트를 가두는 쪽을 냈다면, 이번엔 에이전트가 덜 틀리게 하는 쪽을 낸 셈이고요.
다만 AI가 만든 건 어디까지나 초안이고, 사람이 인증하는 단계가 빠지면 의미가 없다는 점은 엔비디아도 분명히 적어 두었어요. 작은 가게 장부 정도라면 아직은 엑셀이 편하겠죠. 여러분 회사에선 ‘매출’ 정의가 부서마다 같은가요? 엔비디아 오픈소스 소식은 계속 챙겨 볼게요.
출처
· NVIDIA/auto-ontology 깃허브 저장소·README
· NVIDIA Developer — Agent Knowledge Foundation
· NVIDIA 공식 블로그 — Agent Toolkit Expands (2026년 10월 21일)
· GitHub Trending
(2026년 11월 6일 확인)
컴퓨터가 고장 났다면 부산 컴퓨터수리 · 출장수리 부컴에 맡겨 주세요. 부산·울산·김해·양산 어디든 직접 방문합니다.